Trzy etapy, których nie warto mylić
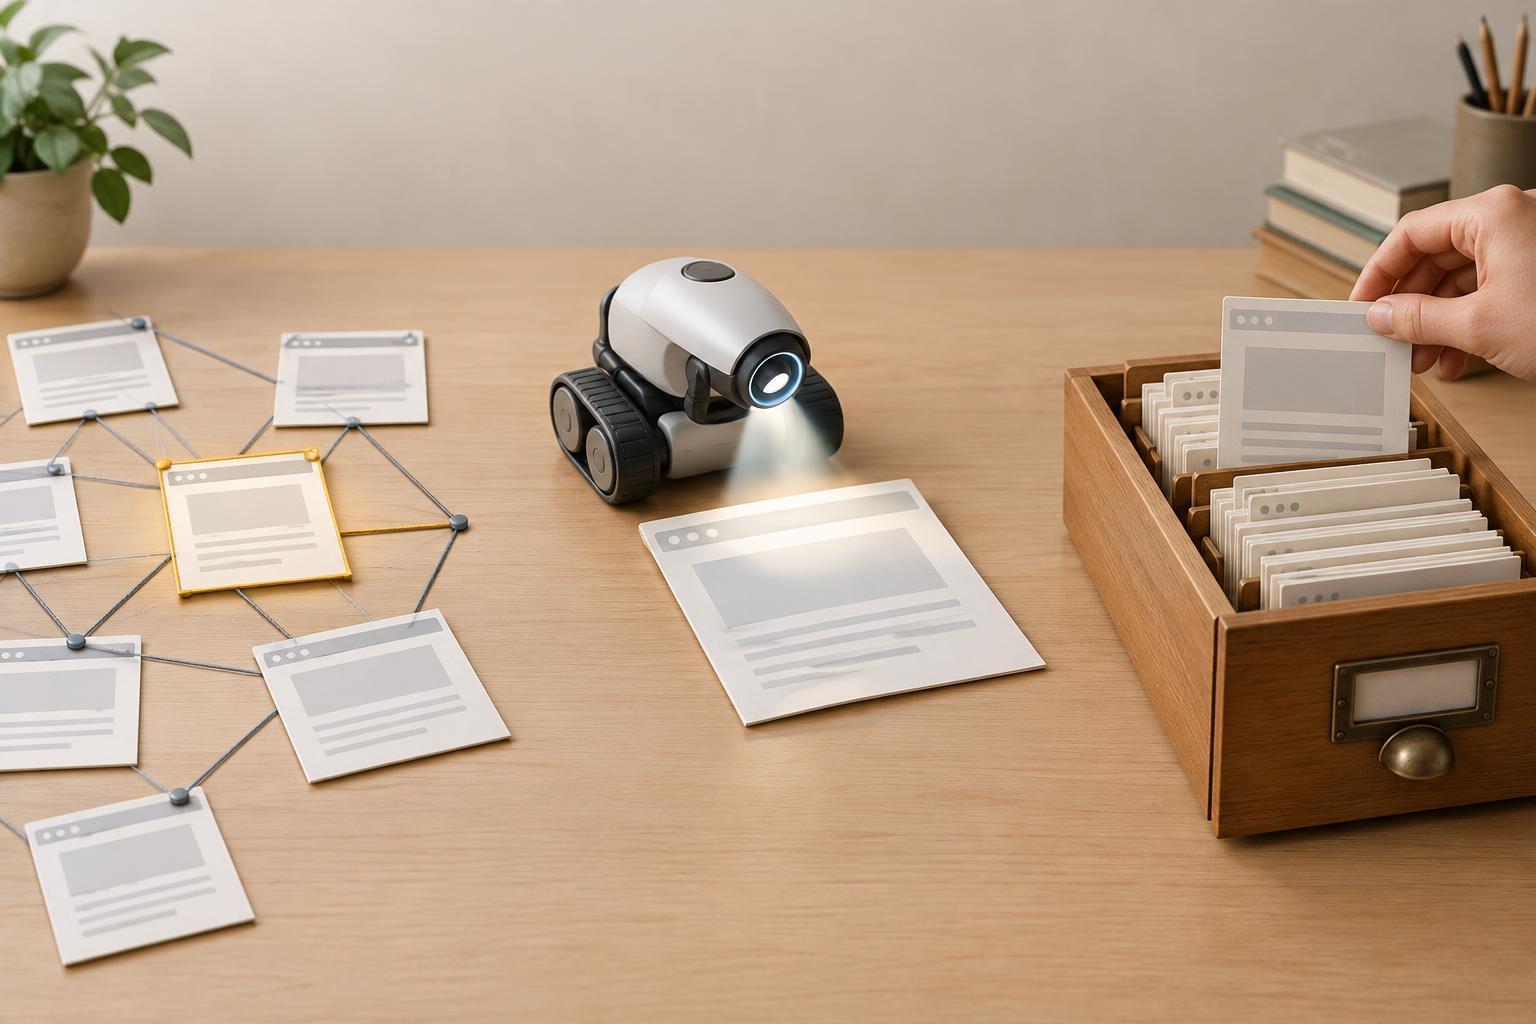
Obecność podstrony w wynikach wyszukiwania nie zaczyna się od jej publikacji. Wyszukiwarka musi najpierw poznać jej adres, następnie móc pobrać zawartość, a na końcu zdecydować, czy uwzględnić stronę w swoim indeksie. Te kroki nazywamy odkrywaniem, skanowaniem i indeksowaniem. Nie każda odkryta strona zostanie zeskanowana, a nie każda zeskanowana trafi do indeksu.
Wyobraź sobie sklep, który dodał nową kategorię produktów. Jeżeli nie prowadzi do niej żaden link i nie ma jej w mapie witryny, robotowi może być trudno znaleźć adres. Jeżeli adres jest znany, ale serwer zwraca błąd, problem dotyczy pobrania strony. Jeżeli strona daje się pobrać, lecz zawiera dyrektywę noindex, przeszkoda pojawia się na etapie indeksowania. Rozróżnienie etapów pozwala sprawdzać właściwą przyczynę zamiast zmieniać przypadkowe ustawienia.
Odkrywanie: skąd wyszukiwarka zna adres?
Odkrywanie polega na znalezieniu adresu URL, nie na ocenie jego treści. Robot może natrafić na adres w linku wewnętrznym, w mapie witryny XML albo na innej stronie. Dla właściciela serwisu szczególnie ważne są linki wewnętrzne: pokazują drogę od strony głównej i stron kategorii do konkretnych podstron. Mapa witryny pomaga wskazać ważne adresy, ale samo umieszczenie w niej URL-a nie gwarantuje skanowania ani indeksowania.
Warto sprawdzić, czy nowa podstrona jest osiągalna przez zwykłe linki, a nie tylko przez wyszukiwarkę wewnętrzną serwisu lub formularz. Pomocna jest też spójność adresów: jeśli nawigacja prowadzi do jednej wersji URL-a, a mapa witryny wymienia inną, trudniej ocenić, która wersja ma być docelowa. W małym serwisie kontrolę można zacząć od przejścia od strony głównej do nowej podstrony tak, jak zrobiłby to odwiedzający.
Skanowanie: czy robot może pobrać stronę?
Skanowanie to próba odwiedzenia znanego adresu i pobrania jego zawartości. Na tym etapie znaczenie mają dostępność serwera, odpowiedź HTTP oraz reguły dostępu dla robotów. Błąd serwera może uniemożliwić pobranie strony, a blokada w pliku robots.txt może powstrzymać robota przed jej odwiedzeniem. Strona wymagająca logowania również zwykle nie będzie dostępna w taki sposób jak publiczna podstrona serwisu.
Sama możliwość otwarcia strony w przeglądarce nie wystarcza do pełnej oceny. Użytkownik może być zalogowany, korzystać z zapisanych danych albo trafiać na inną wersję strony niż robot. Przy diagnostyce sprawdź odpowiedź dla konkretnego URL-a, przekierowania oraz to, czy ważna treść jest dostępna po załadowaniu strony. Jeśli zasadnicza zawartość zależy od skryptów, warto zweryfikować, co faktycznie widzi narzędzie do kontroli adresu w używanej wyszukiwarce.
Indeksowanie: czy strona zostanie uwzględniona?
Indeksowanie oznacza przetworzenie strony i ewentualne włączenie jej do zbioru dokumentów, z którego wyszukiwarka może wybierać wyniki. Nie jest równoznaczne z pojawieniem się podstrony na konkretnej pozycji dla wybranego zapytania. Wyszukiwarka może znać i pobrać URL, a mimo to nie dodać go do indeksu, na przykład gdy strona zawiera noindex lub jest bardzo podobna do innej wersji, którą uzna za właściwszą.
Sprawdź, czy publikowana podstrona nie ma przypadkowej dyrektywy noindex i jaki adres wskazuje jako kanoniczny. Adres kanoniczny pomaga określić preferowaną wersję wśród podobnych stron, ale nie jest poleceniem, które zawsze zostanie przyjęte. Nie próbuj rozwiązywać problemu noindex przez zablokowanie adresu w robots.txt: robot może wtedy nie mieć możliwości odczytania tej dyrektywy. Decyzję o blokowaniu skanowania i decyzję o wykluczaniu z indeksu należy traktować osobno.
Krótka checklista diagnozy konkretnego URL-a
Zacznij od jednego dokładnego adresu, zamiast oceniać całą witrynę naraz. Czy prowadzi do niego link z dostępnej części serwisu? Czy znajduje się w mapie witryny, jeśli mapa obejmuje ten typ stron? Czy nie kierujesz użytkowników i robotów do różnych wariantów adresu? Następnie sprawdź, czy URL nie jest zablokowany dla robota, jaką zwraca odpowiedź i czy przekierowanie prowadzi do zamierzonej strony.
Jeżeli stronę można pobrać, skontroluj noindex, adres kanoniczny oraz zawartość widoczną po załadowaniu. Na końcu porównaj swoje ustalenia z informacją o konkretnym URL-u w narzędziu dla właścicieli witryn danej wyszukiwarki, pamiętając, że raport może nie odzwierciedlać zmian natychmiast. Taka kolejność pomaga ustalić, czy trzeba poprawić drogę do strony, jej dostępność techniczną, czy sygnały dotyczące indeksowania. Nie daje gwarancji dodania strony do indeksu, ale ogranicza zgadywanie.