Dwie drogi przekazania tej samej dyrektywy
Jeśli chcesz wskazać robotom, że dany adres nie powinien trafiać do wyników wyszukiwania, możesz użyć dyrektywy noindex. W przypadku strony HTML często umieszcza się ją w znaczniku meta robots w sekcji head dokumentu. X-Robots-Tag przekazuje taką dyrektywę w nagłówku odpowiedzi HTTP, czyli poza kodem strony. Z punktu widzenia właściciela witryny najważniejsza różnica dotyczy więc miejsca wdrożenia i rodzaju zasobu, którym chce sterować.
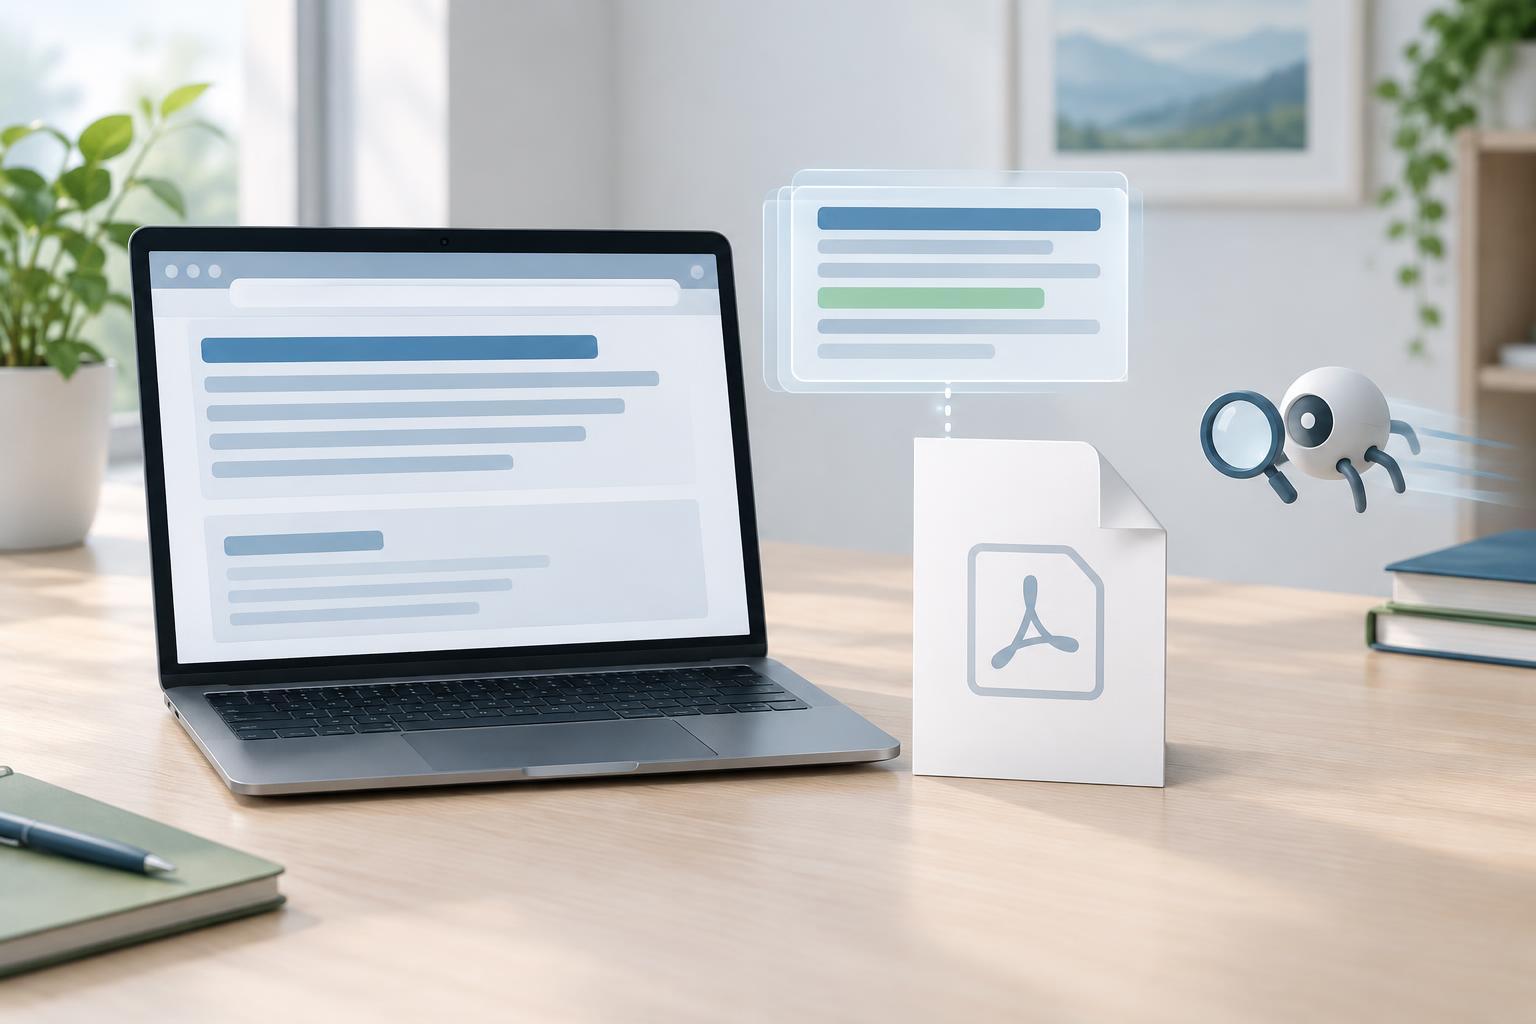
Przykład: witryna publikuje poradnik jako stronę HTML oraz osobny plik PDF. Na stronie można umieścić meta robots, ale PDF nie ma sekcji head, do której dałoby się dodać taki znacznik. Nagłówek X-Robots-Tag można natomiast dołączyć do odpowiedzi serwera zwracającej plik. Może on zawierać na przykład wartość noindex. Nie jest to osobny sposób ukrywania treści przed użytkownikami: plik nadal może być dostępny po otwarciu adresu.
Kiedy nagłówek jest lepszym wyborem
X-Robots-Tag jest szczególnie przydatny dla zasobów innych niż HTML, takich jak pliki PDF. Można go też rozważyć, gdy wiele adresów wymaga tej samej dyrektywy, a łatwiej ustawić ją na poziomie serwera lub aplikacji niż edytować każdą stronę osobno. Przykładem może być wydzielona ścieżka z publicznie dostępnymi dokumentami, których nie chcesz prezentować w wynikach wyszukiwania. Regułę trzeba jednak ograniczyć do właściwych odpowiedzi, aby przypadkiem nie objąć nią innych plików lub stron.
Dla typowej strony HTML meta robots bywa prostszy: osoba zarządzająca szablonem widzi dyrektywę razem z kodem strony. Nagłówek ma przewagę wtedy, gdy nie kontrolujesz kodu dokumentu albo konfiguracja odpowiedzi jest właściwym miejscem zarządzania całą grupą zasobów. Wybór nie wymaga stosowania obu metod naraz. Warto utrzymywać jedno zrozumiałe źródło ustawień, ponieważ rozbieżne dyrektywy w HTML i nagłówkach utrudniają diagnozę.
Noindex wymaga dostępu robota do odpowiedzi
Dyrektywa przesłana w X-Robots-Tag może zostać odczytana dopiero wtedy, gdy robot pobierze odpowiedź danego adresu. Jeśli jednocześnie zablokujesz pobieranie tego adresu w robots.txt, robot może nie zobaczyć nagłówka noindex. Dlatego robots.txt i noindex nie są zamiennikami: pierwszy służy do kontroli dostępu robotów do ścieżek, a drugi przekazuje wskazówkę dotyczącą indeksowania pobranego zasobu.
Jeśli celem jest usunięcie adresu z wyników, nie zakładaj, że sama blokada w robots.txt załatwi sprawę. Jeśli zaś plik zawiera informacje, które nie powinny być publiczne, noindex również nie stanowi zabezpieczenia. W takim przypadku potrzebna jest kontrola dostępu lub usunięcie pliku z publicznego serwera. Przed wdrożeniem ustal więc, czy chcesz ograniczyć indeksowanie, pobieranie przez roboty, czy dostęp ludzi do zasobu — to trzy różne potrzeby.
Jak ustawić dyrektywę bez niezamierzonych skutków
Najpierw sporządź listę adresów lub typów plików, których ma dotyczyć reguła. Następnie ustal, w którym miejscu powstaje odpowiedź: w aplikacji, serwerze WWW, systemie obsługującym pliki czy warstwie pośredniej, na przykład CDN. Dyrektywa musi być obecna w odpowiedzi właściwego adresu. Jeżeli adres przekierowuje, sprawdź także odpowiedź pod adresem docelowym; nagłówek ustawiony wyłącznie na przekierowaniu nie zastępuje kontroli zasobu, do którego ostatecznie trafia użytkownik.
Nie ustawiaj noindex dla całej domeny tylko po to, by rozwiązać problem jednej grupy dokumentów. Reguły oparte na rozszerzeniu pliku lub fragmencie ścieżki też wymagają ostrożności: w tej samej lokalizacji mogą z czasem pojawić się zasoby, które powinny pozostać indeksowane. Zapisz, kto odpowiada za konfigurację, i sprawdź kilka adresów poza zakresem reguły. Dzięki temu łatwiej zauważyć, czy zmiana nie rozlała się na ważne podstrony.
Krótka lista kontroli po wdrożeniu
Sprawdź rzeczywistą odpowiedź HTTP dla przykładowego adresu objętego regułą. Narzędzie pokazujące nagłówki powinno ujawnić X-Robots-Tag i jego wartość. Gdy używasz polecenia curl -I, pamiętaj, że wysyła ono żądanie HEAD; przy wątpliwościach skontroluj także odpowiedź na zwykłe żądanie GET. Zweryfikuj kod odpowiedzi, ewentualne przekierowania oraz to, czy nagłówek pojawia się przy końcowym zasobie.
Na koniec otwórz przykład adresu, który ma pozostać indeksowany, i upewnij się, że nie otrzymuje przypadkowego noindex. Sprawdź również, czy robots.txt nie uniemożliwia pobrania zasobów, dla których robot ma odczytać dyrektywę. Taka kontrola nie daje gwarancji konkretnego stanu wyników wyszukiwania, ale pozwala potwierdzić, że witryna wysyła zamierzony sygnał techniczny.