Czym jest budżet skanowania i czego nie oznacza
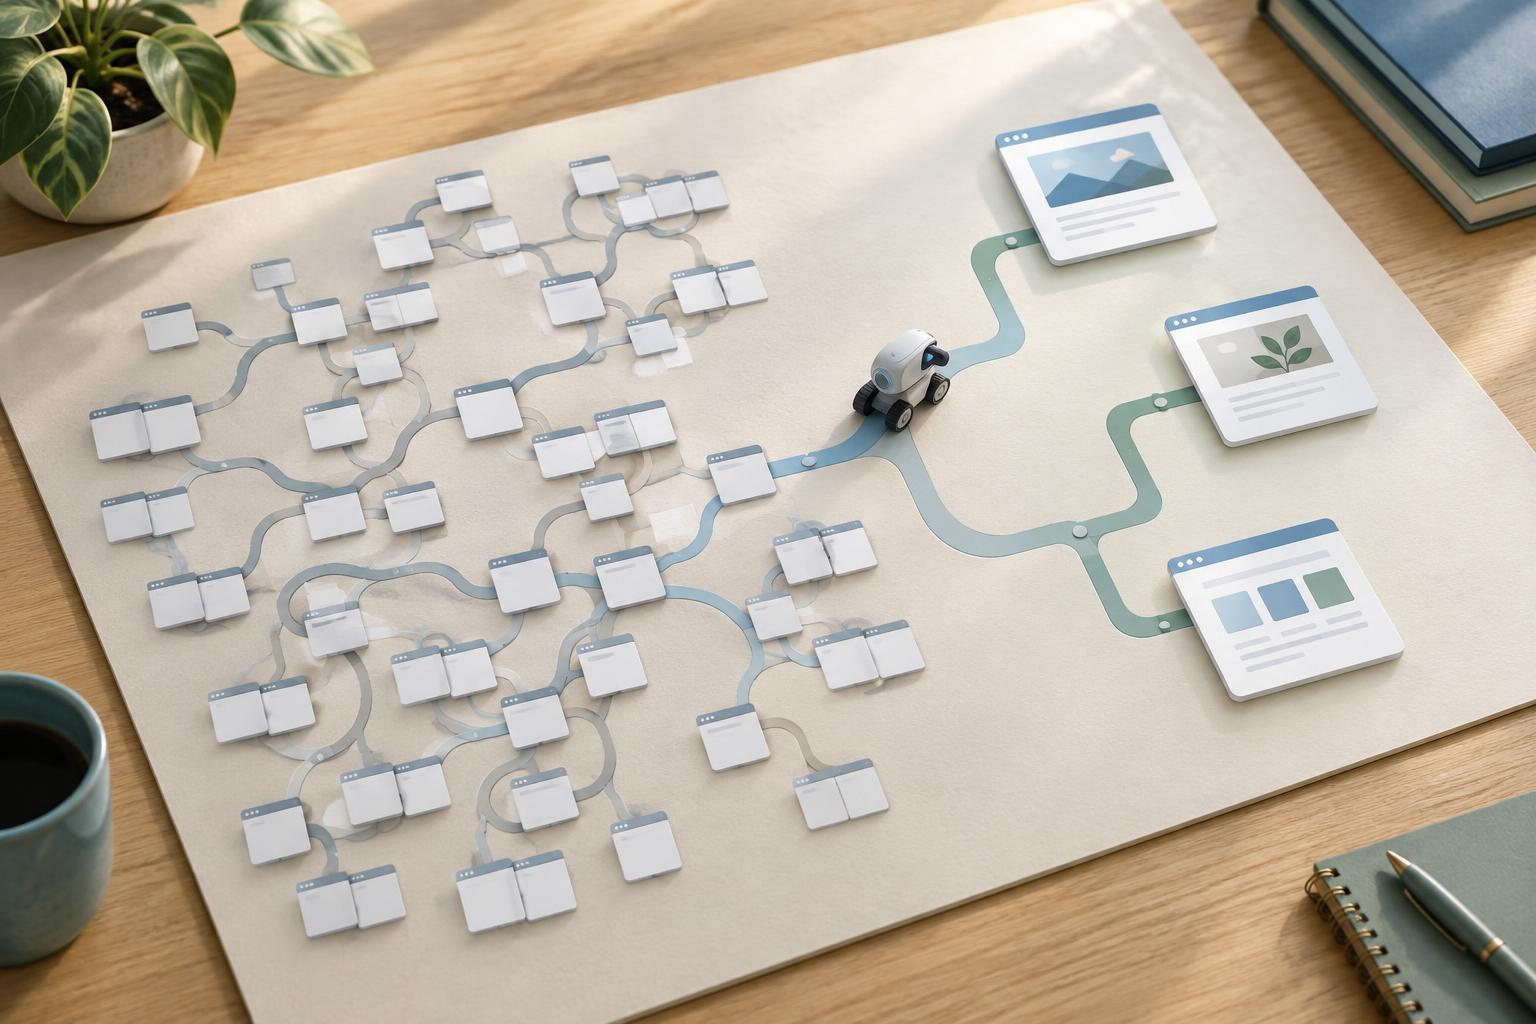
Budżet skanowania to praktyczne określenie czasu i zasobów, jakie robot wyszukiwarki przeznacza na odwiedzanie adresów w danej witrynie. Nie jest to stała liczba wizyt przydzielona raz na zawsze. Częstotliwość skanowania zależy między innymi od tego, ile adresów robot zna, jak serwer odpowiada na żądania oraz czy treści wydają się warte ponownego sprawdzenia. Różne roboty mogą przy tym zachowywać się inaczej.
Skanowanie nie jest tym samym co indeksowanie. Robot może pobrać stronę, a wyszukiwarka mimo to nie musi umieścić jej w indeksie. Może też znać adres z linku, lecz jeszcze go nie odwiedzić. Dlatego większa liczba wizyt sama w sobie nie jest celem. Chodzi o to, by ważne podstrony były dostępne, łatwe do znalezienia i nie ginęły wśród wielu mało przydatnych wariantów adresów.
Kiedy warto zająć się tematem
W małym serwisie z kilkudziesięcioma stabilnymi podstronami budżet skanowania rzadko jest pierwszym podejrzanym, gdy strona nie pojawia się w wynikach. Najpierw warto sprawdzić, czy adres nie jest blokowany, czy zwraca poprawną odpowiedź, czy prowadzą do niego linki wewnętrzne i czy sama treść jest odpowiednia do indeksowania.
Temat staje się ważniejszy w dużym sklepie, serwisie ogłoszeniowym lub portalu, gdzie filtry, sortowanie i wyszukiwarka wewnętrzna potrafią tworzyć liczne adresy dla podobnych zestawów treści. Sygnałem do sprawdzenia sytuacji może być też to, że nowe lub istotnie zmienione strony długo czekają na odwiedzenie, podczas gdy robot regularnie pobiera niepotrzebne warianty. To wskazówka do diagnozy, nie dowód, że samo skanowanie jest przyczyną problemu.
Gdzie najczęściej powstają zbędne adresy
Wyobraź sobie kategorię „buty”, którą można sortować według ceny i filtrować według rozmiaru, koloru oraz marki. Jeżeli każda kombinacja tworzy osobny adres, robot może odkryć wiele podobnych stron. Podobny efekt dają parametry śledzące w linkach, identyfikatory sesji w adresach czy kalendarze pozwalające przechodzić bez końca do kolejnych terminów. Nie każdy taki adres jest zbędny: użyteczna, odrębna podkategoria może zasługiwać na własną stronę. Decyzję warto podejmować według wartości danej strony dla użytkownika.
Wizyty mogą pochłaniać również długie łańcuchy przekierowań, linki do usuniętych produktów, powielone ścieżki prowadzące do tej samej treści oraz adresy generujące błędy serwera. Odpowiedź 404 dla rzeczywiście usuniętej strony nie jest jednak czymś, co trzeba za wszelką cenę ukrywać. Ważniejsze jest usunięcie nieaktualnych linków wewnętrznych i niewysyłanie takich adresów w mapie witryny.
Jak uporządkować skanowanie bez blokowania ważnych stron
Zacznij od architektury i linkowania. Ważne strony powinny być osiągalne przez czytelne odnośniki, a nie wyłącznie przez formularz wyszukiwania lub skomplikowaną kombinację filtrów. W mapie XML umieszczaj adresy, które chcesz przedstawiać jako właściwe wersje stron, i aktualizuj ją po zmianach. Mapa pomaga wskazać adresy do odkrycia, ale nie gwarantuje ani ich odwiedzenia, ani indeksowania.
Jeżeli kilka adresów pokazuje zasadniczo tę samą treść, zadbaj o spójne linki wewnętrzne i rozważ wskazanie wersji kanonicznej. Wskazanie kanoniczne jest sygnałem, a nie poleceniem, które zawsze zostanie przyjęte. Dla zbędnych kombinacji filtrów rozważ ograniczenie ich tworzenia lub linkowania, zamiast pozostawiać robotowi nieograniczoną liczbę ścieżek. Reguły w robots.txt mogą ograniczyć pobieranie wybranych adresów, ale nie służą do usuwania ich z indeksu. Jeśli robot nie może otworzyć strony, nie zobaczy też umieszczonej na niej dyrektywy noindex.
Sprawdź również działanie serwera. Powtarzające się błędy 5xx, przeciążenia lub wolne odpowiedzi mogą utrudniać pobieranie stron. Przekierowania prowadź możliwie bez zbędnych etapów, a usunięte treści obsługuj zgodnie z ich rzeczywistym stanem: przez odpowiedź 404 lub 410 albo przez przekierowanie do trafnego zamiennika.
Krótka lista kontrolna do samodzielnej diagnozy
Przejrzyj raporty skanowania i indeksowania dostępne dla witryny oraz, jeśli masz do nich dostęp, logi serwera. Sprawdź, które grupy adresów są często pobierane i czy ważne strony otrzymują wizyty. Przy analizie logów upewnij się, że rozpoznajesz właściwego robota; sama nazwa zapisana w nagłówku żądania nie wystarcza do jego potwierdzenia. Porównuj grupy adresów i obserwuj zmiany w czasie, zamiast wyciągać wnioski z pojedynczego dnia.
Następnie odpowiedz na kilka pytań: Czy filtry i parametry tworzą wiele podobnych adresów? Czy mapa witryny zawiera tylko właściwe strony? Czy ważne podstrony mają linki wewnętrzne? Czy robot trafia na błędy serwera, niepotrzebne przekierowania lub linki do usuniętych treści? Po poprawkach ponownie sprawdź te same grupy adresów. Celem nie jest osiągnięcie określonej liczby wizyt, lecz ułatwienie robotom dostępu do stron, które naprawdę chcesz udostępniać w wyszukiwarce.