Najpierw rozdziel pobieranie od indeksowania
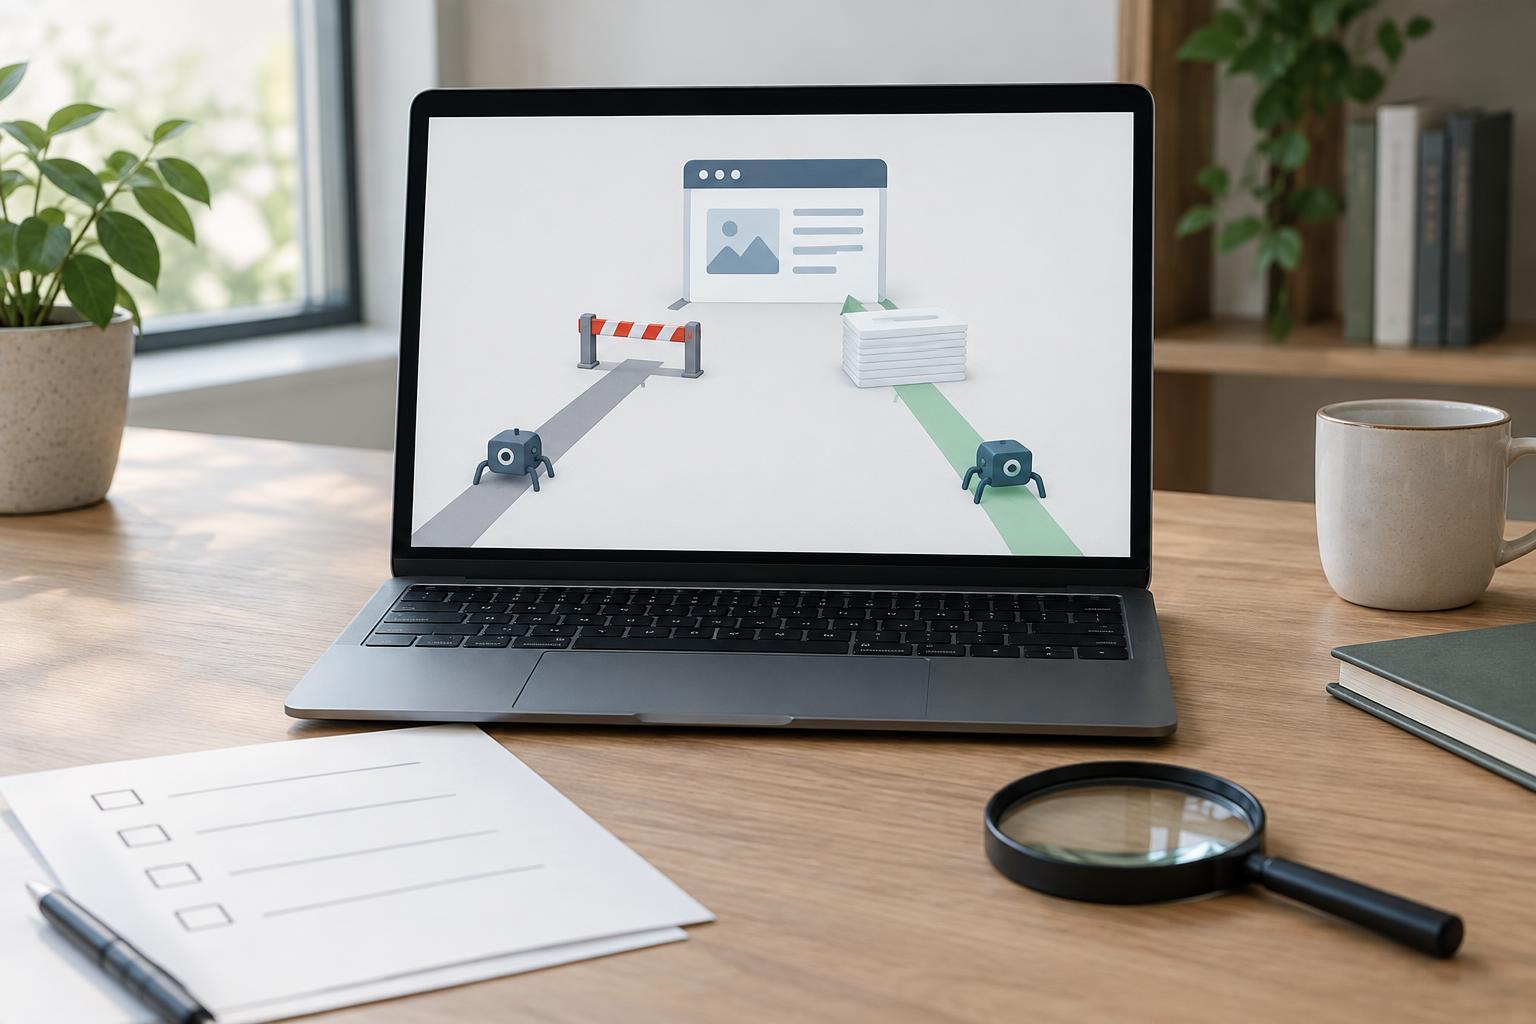
Gdy podstrony brakuje w wynikach wyszukiwania, łatwo uznać, że „blokuje ją robots.txt”. To tylko jedna z możliwości. Plik robots.txt przekazuje robotom reguły dotyczące pobierania adresów. Dyrektywa noindex mówi natomiast, że strony nie należy umieszczać w indeksie. Te mechanizmy działają na różnych etapach: robot musi zwykle móc pobrać stronę, aby zobaczyć umieszczony na niej noindex.
Blokada pobierania w robots.txt nie jest więc pewnym sposobem na usunięcie adresu z wyników. Wyszukiwarka może poznać zablokowany URL choćby z odnośnika na innej stronie, nawet jeśli nie może odczytać jego treści. Odwrotnie, adres dostępny dla robota może nie zostać zaindeksowany z wielu powodów. Sama możliwość pobrania strony nie jest obietnicą jej obecności w wynikach.
Ustal dokładny adres i sprawdź odpowiedź serwera
Zacznij od zapisania konkretnego URL, który diagnozujesz. Sprawdź protokół, nazwę hosta, ścieżkę i ewentualny końcowy ukośnik. Adresy z „www” i bez „www” mogą prowadzić przez różne przekierowania, a plik robots.txt odnosi się do właściwego hosta i protokołu. Nie zakładaj, że reguła zauważona dla jednego wariantu automatycznie opisuje wszystkie pozostałe.
Następnie sprawdź kod odpowiedzi HTTP i łańcuch przekierowań. Jeśli adres zwraca przekierowanie, badaj także stronę docelową: to ona może zawierać noindex lub podlegać blokadzie. Jeśli serwer zwraca błąd, wymaga logowania albo wyświetla inną treść robotowi niż zwykłemu użytkownikowi, problem nie musi leżeć w robots.txt. Właściciel serwisu może zacząć od narzędzi deweloperskich przeglądarki, a następnie porównać wynik z narzędziem do inspekcji URL dostępnym w używanej usłudze dla webmasterów.
Zweryfikuj reguły robots.txt dla badanej ścieżki
Otwórz plik robots.txt dla właściwego hosta i protokołu, po czym odszukaj reguły dotyczące robota, którego sprawdzasz. Zwróć uwagę na grupy User-agent oraz dopasowanie dyrektyw Allow i Disallow do ścieżki URL. Nie oceniaj pliku tylko po tym, że zawiera słowo „Disallow”: reguła może dotyczyć innego robota albo innej części serwisu. Jeśli korzystasz z testera robots.txt, wprowadź dokładny badany adres i właściwego robota.
Przykład: sklep ma regułę blokującą ścieżkę /filtry/, a karta produktu przypadkowo znajduje się pod adresem /filtry/produkt-a. Robot może nie pobrać tej karty, mimo że otwiera się ona w przeglądarce. W takiej sytuacji sprawdź, czy ścieżka jest zamierzona oraz czy reguła nie obejmuje większej części serwisu, niż planowano. Zmianę w robots.txt wprowadzaj dopiero po ustaleniu, które adresy powinny być dostępne dla robotów.
Jeśli pobieranie jest możliwe, poszukaj noindex
Na dostępnej stronie sprawdź znacznik meta robots w kodzie HTML, na przykład dyrektywę noindex przypisaną do odpowiednich robotów. Skontroluj też nagłówek HTTP X-Robots-Tag: on również może przekazywać noindex, nawet gdy w HTML nie ma takiego znacznika. W serwisach generujących treść za pomocą JavaScript warto porównać początkowy kod HTML z wersją strony przetworzoną przez narzędzie inspekcyjne. Dzięki temu łatwiej ustalić, jakie dyrektywy robot może zobaczyć.
Uważaj na pozornie sprzeczne ustawienia. Jeśli robots.txt zabrania pobrania strony, robot może nie dotrzeć do umieszczonego na niej noindex. Jeśli celem jest wykluczenie dostępnej publicznie strony z indeksu, samo zablokowanie jej w robots.txt nie zastępuje noindex. Z kolei dla treści, które nie powinny być publicznie dostępne, dyrektywy dla robotów nie są zabezpieczeniem: potrzebna jest kontrola dostępu.
Zamknij diagnozę krótką checklistą
Zapisz wynik w stałej kolejności: dokładny URL i jego warianty; kod odpowiedzi oraz przekierowania; możliwość pobrania strony według robots.txt; meta robots i X-Robots-Tag na odpowiedzi docelowej. Sprawdź również, czy wskazany adres kanoniczny prowadzi do innej strony. Wskazanie kanoniczne nie jest tym samym co noindex, ale może pomóc wyjaśnić, dlaczego wyszukiwarka wybiera do prezentacji inny URL.
Po poprawce wykonaj kontrolę ponownie na tym samym adresie. Usuń niezamierzony noindex albo zmień regułę robots.txt tylko wtedy, gdy dana podstrona rzeczywiście ma być dostępna dla robotów i kwalifikować się do indeksowania. Zanotuj, co zostało zmienione oraz jaki wynik pokazuje ponowna inspekcja. Dzięki temu łatwiej odróżnić usuniętą blokadę techniczną od sytuacji, w której strona jest dostępna, lecz nadal nie pojawia się w wynikach.